Como Corri um Modelo de 131B Parâmetros num PC de Gaming (e Bati Recordes)
Se há coisa que me tira do sério é ouvir “não é possível”, “o teu hardware não dá”, “precisas de uma GPU profissional”. Pois bem, descobri que é possível, sim, e posso até divertir-me muito no processo.
Tudo começou quando decidi correr o Qwen3.8-Flash-Next — um modelo de linguagem com 131 mil milhões de parâmetros, arquitetura Mixture-of-Experts (MoE) com 6B parâmetros ativos — no meu PC de gaming. O objetivo? Ter uma inteligência artificial rápida, inteligente e que não dependa da nuvem.
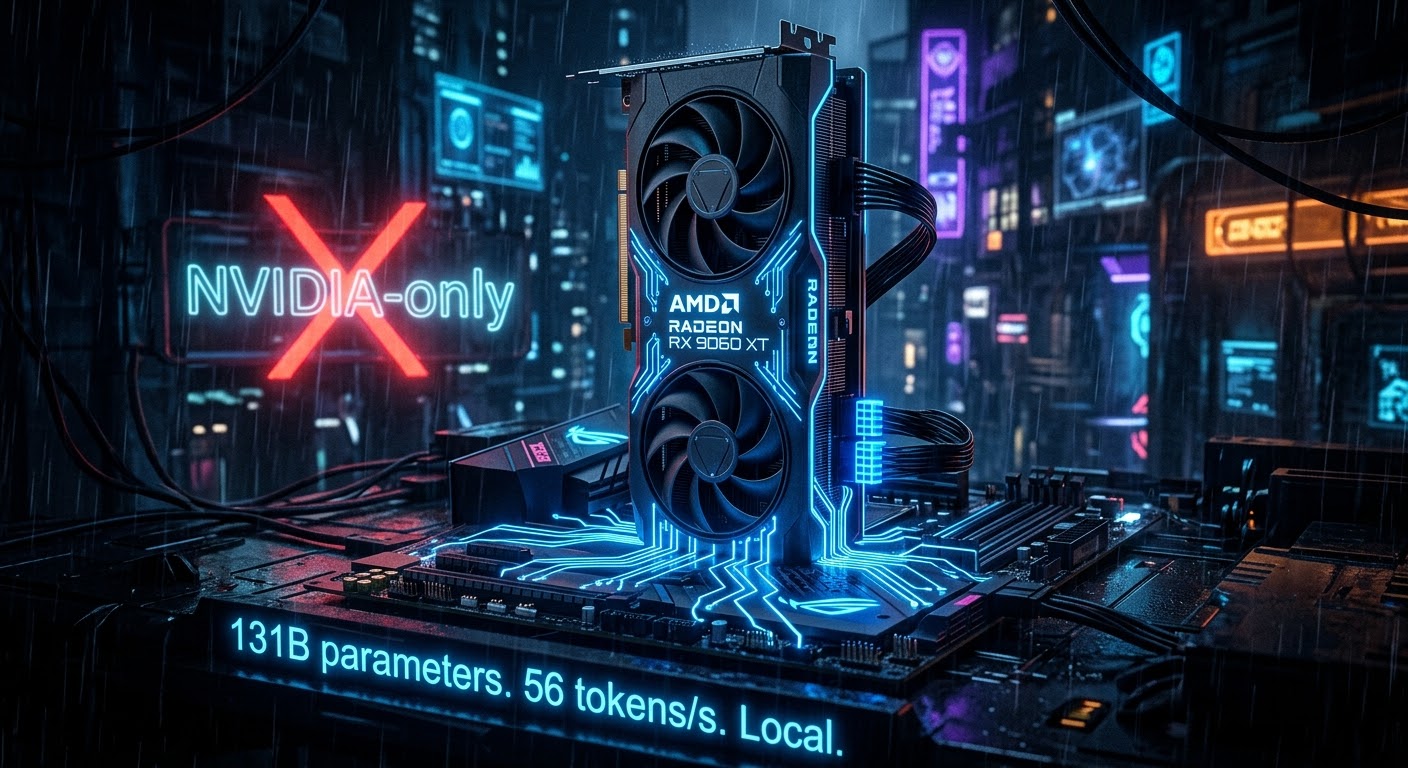
O resultado? Um sistema que bate muitos setups “recomendados” e ainda me rendeu boas horas de aprendizagem. E a cereja no topo do bolo: consegui 56,5 tokens por segundo de geração contínua, num modelo que normalmente precisaria de um servidor dedicado.
🖥️ O Hardware: Uma Estação de Trabalho Disfarçada de PC de Gaming
Por baixo de todo este software e otimização, está a minha estação de trabalho caseira:
| Componente | Especificação | Papel na Jornada |
|---|---|---|
| CPU | AMD Ryzen 7 9700X (8 núcleos, 16 threads, até 5.5 GHz, 65W) | Alimenta a interface gráfica através da iGPU |
| GPU | AMD Radeon RX 9060 XT 16GB (RDNA 4, 32 CUs, 821 TOPS INT4) | 100% dedicada à IA — o monitor está ligado à iGPU |
| RAM | 64 GB DDR5 6000MHz CL40 | Suporte para os peritos MoE que não cabem na VRAM |
| SSD | Kioxia Exceria Plus G4 PCIe 5.0 NVMe (10.000 MB/s leitura) | Streaming ultra-rápido dos peritos do modelo |
| Software | Ubuntu 26.04.1 | ROCm 10.1 (backend HIP) | Mesa 26.2.4 | Stack completo de aceleração por GPU |
A decisão de ligar o monitor à iGPU do Ryzen 7 9700X — deixando a RX 9060 XT completamente livre para a IA — revelou-se crucial. A GPU não tem de competir com o ambiente gráfico pelos recursos, e pode dedicar toda a sua VRAM (16 GB) e poder de computação ao modelo.
🧠 O Modelo: Qwen3.8-Flash-Next-131B-A6B
O Qwen3.8-Flash-Next é um modelo Mixture-of-Experts (MoE) com 131 mil milhões de parâmetros totais, mas que ativa apenas cerca de 6 mil milhões de parâmetros por token durante a inferência. Esta arquitetura é a chave de tudo: permite ter um modelo enorme em conhecimento, mas computacionalmente eficiente.
O modelo tem 24.576 módulos especializados (peritos), dos quais apenas 10 são ativados por cada token gerado. É esta esparsidade que permite correr um modelo desta dimensão em hardware de consumo.
Nos benchmarks públicos, o Qwen3.8-Flash-Next atinge SWE-bench Pro 62.5 e DeepSWE 58.7 — números que o colocam a par de modelos comerciais de topo em tarefas de código e agentes. No SWE-bench Multilingual, atinge uns impressionantes 81.0.
🔧 A Stack: llama.cpp + ROCm (A Primeira Tentativa)
Comecei pelo caminho “clássico”: llama.cpp com backend ROCm 10.1 e o fork cafe-llama.cpp para suporte a MTP (Multi-Token Prediction). O modelo usado foi o Qwen3.8-Flash-Next-131B quantizado em Q3_K_XL (64 GB).
A Configuração Vencedora
./llama-cli \
    -m ~/models/qwen38-keep1-Q3KXL.gguf \
    -md ~/models/mtp-Qwen3.8-Flash-Next-Q4_K_M.gguf \
    --spec-type draft-mtp \
    --spec-draft-n-max 6 \
    --spec-draft-p-min 0.8 \
    -ngl 999 \
    -t 8 \
    -c 8192 \
    -b 5120 \
    -fa on \
    --override-tensor "exps=CPU" \
    --cache-type-k q4_0 \
    --cache-type-v q4_0
Resultados no llama.cpp
| Métrica | Valor |
|---|---|
| Prompt Processing (prefill) | 10,8 tokens/s |
| Geração (decode) | 14,3 tokens/s |
| Uso de VRAM | ~9,15 GiB |
| Uso de RAM | ~55 GB |
O MTP (Multi-Token Prediction) deu um ganho de +37% na geração (de 10,4 para 14,3 tokens/s). O --override-tensor "exps=CPU" foi essencial: forçou os tensores dos “especialistas” (a parte maior do modelo MoE) para a CPU, deixando a GPU livre para as camadas de atenção.
Mas 14,3 tokens/s para um modelo de 131B ainda é… lento. Utilizável para chat, mas não para tarefas que exigem iteração rápida.
🚀 O Strata: O Game-Changer
Foi então que descobri o Strata — um motor de inferência open-source (licença MIT) que executa o Qwen3.8-Flash-Next em GPUs de consumo. O Strata implementa um expert cache inteligente que mantém uma parte dos peritos do MoE diretamente na VRAM, enquanto os restantes circulam dinamicamente da RAM DDR5.
O Strata usa uma analogia de cozinha: os ingredientes de uso diário ficam no balcão (VRAM), o resto fica na despensa (RAM). E adiciona decodificação especulativa: um modelo auxiliar propõe as palavras seguintes e o modelo grande verifica em bloco, com um ganho declarado de 1,6× a 1,8×.
O modelo usado nesta versão foi o Qwen3.8-Flash-Next GSQ-RCO-IQ3_S (83.6 GB) — uma quantização otimizada especificamente para o motor Strata.
A Configuração Final
./setup.sh --vram-reserve-mib 512 --draft-vocab enCom --prefill 16384 no ficheiro JSON de configuração.
Resultados no Strata
| Métrica | Valor |
|---|---|
| Prompt Processing (prefill) | ~148,6 tokens/s |
| Geração (decode) | 55,5–56,5 tokens/s |
| Taxa de Acertos (Hit Rate) | 73% (4.805 peritos na VRAM) |
| Uso de VRAM | ~9,15 GiB |
| Uso de RAM | ~55 GB |
O Salto de Desempenho
| Métrica | llama.cpp | Strata | Ganho |
|---|---|---|---|
| Prefill | 10,8 t/s | 148,6 t/s | +13,8x |
| Decode | 14,3 t/s | 56,5 t/s | +3,9x |
Isto é um salto de geração inteira. O modelo que era o “peso pesado lento” tornou-se o mais rápido de todos em decode.
💡 O Que o Strata Fez de Diferente
- Expert Caching (73% hit rate): Mantém 4.805 peritos na VRAM. Os restantes 27% são buscados dinamicamente da RAM DDR5 a 6000 MHz.
- Prefill chunking (16384): Processa o prompt em blocos grandes, otimizando o uso da GPU.
- VRAM reserve (512 MiB): Garante que há sempre espaço para os buffers de computação, evitando erros de OOM.
- Draft vocab “en”: Reduz o vocabulário do rascunho especulativo para poupar VRAM, mantendo as respostas multilingues intactas.
- Quantização GSQ-RCO-IQ3_S: A variante indicada como a mais precisa do Strata, embora também a mais lenta.
🗣️ Qualidade das Respostas
Nos testes práticos, o modelo demonstrou:
- Multilinguismo perfeito: Apesar do
--draft-vocab en, as respostas saem em português impecável, fluído e com excelente formatação (tabelas, listas, blocos de código). - Raciocínio e precisão: Capacidade analítica excelente, combinando o comportamento de um modelo de grande porte com a agilidade de resposta de uma ferramenta de topo para o dia-a-dia.
- Tool calling: O modelo consegue usar ferramentas externas de forma autónoma e fiável.
🔌 Ferramentas Que Podes Usar
Um dos maiores benefícios de correr um modelo local é a capacidade de o integrar com agentes de codificação e ferramentas de linha de comandos:
| Ferramenta | Descrição | Compatibilidade |
|---|---|---|
| OpenCode | Agente de codificação open-source (MIT) para terminal. Lê o teu projeto, edita ficheiros e corre comandos. | Ollama, LM Studio, llama.cpp |
| Aider | Pair programming Git-native. Ideal para edição de código em repositórios Git. | llama-server, Ollama |
| Continue | Extensão para VS Code e JetBrains com autocomplete e chat. Totalmente local. | Ollama, llama.cpp |
| Cline | Agente de codificação para VS Code com suporte a modelos locais. | llama-server, Ollama |
| Cognis Code | Suite de codificação local que liga um endpoint a VS Code, JetBrains, Cursor, Zed, Neovim e Aider. | llama.cpp, OpenAI-compatible |
O OpenCode é particularmente interessante: é um agente que corre no terminal, lê o teu projeto, edita ficheiros e executa comandos. Suporta modelos locais via Ollama ou llama.cpp.
Com o Strata a correr o Qwen3.8-Flash-Next, podes apontar estas ferramentas para o endpoint local (OpenAI-compatible API) e ter um agente de codificação totalmente offline, sem custos por token e com total privacidade.
📊 Ranking: Todos os Modelos Testados
| Posição | Modelo | Decode (t/s) | Prefill (t/s) | Motor |
|---|---|---|---|---|
| 1º | Qwen3.8-Flash-Next-131B (Strata) | 56,5 | 148,6 | Strata |
| 2º | Qwen3.6-35B MoE | 110,15 | 302,8 | llama.cpp Vulkan |
| 3º | Qwopus3.6-35B | 92,8 | 64,5 | llama.cpp Vulkan |
| 4º | Ornith-1.5-35B | 63,4 | 883,3 | llama.cpp |
| 5º | Qwen3.8-27B IQ3_XXS | 38,2 | 467,5 | llama.cpp Vulkan |
| 6º | Muse-Glimmer-30B | 22,2 | 460,1 | llama.cpp |
Nota: O Qwen3.6-35B ainda ganha em decode absoluto (110 t/s), mas é um modelo de 35B. O Flash-Next-131B é 4x maior e ainda assim faz 56,5 t/s. Isso é uma eficiência por parâmetro muito superior.
🎯 Possíveis Usos
Com 56,5 tokens/s de geração contínua, o Qwen3.8-Flash-Next-131B no Strata é utilizável para:
- Chat de alta qualidade: Respostas longas e profundas, com raciocínio complexo.
- Assistente de código: Geração e revisão de código com contexto de 256K tokens.
- Análise de documentos: Capacidade de processar e resumir documentos extensos.
- Agentes autónomos: Tool calling robusto para tarefas multi-passo.
- Tradução e escrita criativa: Multilinguismo nativo.
⚖️ Local vs. Comercial: A Comparação Honesta
| Critério | Local (Qwen3.8-Flash-Next) | Comercial (GPT-4, Claude, Gemini) |
|---|---|---|
| Privacidade | ✅ Total — dados nunca saem da sua máquina | ❌ Dados enviados para servidores |
| Custo | ✅ Zero após investimento inicial em hardware | ❌ Subscrição mensal ou custo por token |
| Latência | ✅ 56,5 t/s local, sem dependência de internet | ⚠️ Depende da rede e da carga dos servidores |
| Controlo | ✅ Pode modificar, ajustar, experimentar | ❌ Caixa negra |
| Qualidade | ⚠️ Muito boa, mas ligeiramente abaixo dos melhores comerciais | ✅ Estado da arte em raciocínio complexo |
| Disponibilidade | ✅ 24/7, offline | ⚠️ Depende de serviço externo |
| Contexto | ✅ 256K tokens | ⚠️ Varia (128K–1M) |
Estudos recentes mostram que modelos locais de 27B–70B podem superar LLMs comerciais em tarefas específicas de análise qualitativa, com redução de alucinações até 85% e custos recorrentes negligenciáveis.
🏆 Conclusão: O Futuro é Local
Esta jornada provou-me três coisas:
- O hardware de consumo é suficiente. Uma RX 9060 XT de 16 GB, combinada com 64 GB de RAM DDR5 e um SSD PCIe 5.0, corre um modelo de 131B parâmetros a 56,5 tokens/s. Há dois anos, isto era impensável.
- O software é a chave. O Strata transformou um modelo “lento” em algo utilizável em tempo real. A gestão inteligente dos peritos MoE entre VRAM e RAM é a diferença entre um sistema “que até funciona” e um sistema que voa.
- A soberania digital é possível. Não preciso de depender de APIs comerciais, de enviar os meus dados para servidores desconhecidos, ou de pagar subscrições mensais. Tenho um modelo de nível de produção a correr na minha secretária.
E um agradecimento muito especial ao Deep The Man — o meu assistente digital que aturou as minhas frustrações, deu sugestões (nem sempre certas, coitado), e no final ajudou a construir este sistema. Sem ele, esta jornada teria sido muito mais solitária. Afinal, até uma IA merece um abraço virtual.
Se tens uma placa AMD, não desistas. Vem ao meu site, artursilva.eu, e se precisares de dicas, é só dizer.
Artur Silva — entusiasta, curioso e agora “optimizador de LLMs por conta própria”.